Harness² verbessert Agenten-Harnesses durch rekursive Anpassung
Google Research lässt nicht die Modellgewichte, sondern System-Prompt, Speicher, Skills, Werkzeuge und weitere Teile der Agentenumgebung aus Ausführungsbelegen lernen.
Ein leistungsfähigeres Modell ist nicht die einzige Möglichkeit, einen KI-Agenten zu verbessern. Google Research setzt mit Harness² an der Umgebung an, in der das Modell arbeitet: dem Agenten-Harness. Das quelloffene Forschungsframework verändert dessen Anweisungen, Hilfsmittel und Koordination anhand beobachteter Ausführungen, während die Modellgewichte unangetastet bleiben.
Das Neue daran ist die Verbindung zweier Rekursionsebenen. Die erste sucht eine bessere Konfiguration für die gerade bearbeitete Aufgabe. Die zweite verdichtet erfolgreiche Erfahrungen aus abgeschlossenen Aufgaben und stellt sie für spätere Aufträge bereit. Harness² ist damit kein weiterer Coding-Agent, sondern eine experimentelle Optimierungsschicht für bestehende OpenCode- und Codex-basierte Agenten. Das Repository steht unter Apache 2.0; Google kennzeichnet das Projekt ausdrücklich als Forschungssoftware und nicht als offiziell unterstütztes Produkt. Repository von Google Research
Acht veränderbare Teile statt neuer Modellgewichte
Der Harness umfasst bei Harness² acht Komponenten: System-Prompt, Guardrails, Speicher, Werkzeughinweise, Skills, Skripte, Subagenten und Plugins. Diese Aufteilung macht die Verbesserung konkreter als eine allgemeine Aufforderung, der Agent solle beim nächsten Versuch „besser arbeiten“.
Bei einer Rechercheaufgabe könnte eine Variante beispielsweise präzisere Hinweise zur Auswahl und Dokumentation von Werkzeugen enthalten. Bei wiederkehrenden Dateiaufgaben kann ein bereitgestelltes Skript die zuverlässigere Änderung sein. Benötigt eine Aufgabe mehrere unabhängige Untersuchungen, lässt sich stattdessen die Aufteilung auf Subagenten anpassen. Der Ansatz entscheidet also nicht im Voraus, dass jeder Fehler mit einem längeren Prompt behoben werden müsse.
Das unterscheidet Harness² auch von Fine-Tuning: Es entstehen keine neuen Modellgewichte. Änderungen bleiben als lesbare Bestandteile der Laufzeitumgebung erhalten und können einzeln untersucht werden. Ein Team kann dadurch nachvollziehen, ob ein Resultat etwa aus einem neuen Skill, einer anderen Speicherinformation oder einer veränderten Werkzeugbeschreibung hervorgegangen ist. Beschreibung der bearbeitbaren Komponenten
Varianten auf derselben Aufgabe erproben
Die erste Rekursionsebene folgt dem im Forschungspapier beschriebenen Prinzip Propose–Probe–Compose. Zunächst werden mögliche Harness-Änderungen vorgeschlagen. Anschließend laufen Proben auf derselben Aufgabe, damit das tatsächliche Verhalten der Varianten vergleichbar wird. Geeignete Änderungen werden schließlich zu einem verbesserten Harness zusammengesetzt.
Entscheidend ist dabei die Bewertung anhand von Ausführungsbelegen. Harness² betrachtet nicht allein, ob eine Änderung sprachlich plausibel klingt, sondern wie sich der Agent mit ihr verhält. Laut Paper benötigt dieser Vergleich keine vorab hinterlegte Referenzantwort. Das ist besonders für offene Aufgaben nützlich, bei denen mehrere Lösungswege korrekt sein können oder eine einzelne Musterlösung das gewünschte Verhalten nur unvollständig abbildet.
Ein Beispiel ist eine umfangreiche Informationssuche: Eine Variante ergänzt einen Werkzeughinweis für gezieltere Abfragen, eine zweite stellt einen passenden Skill bereit und eine dritte verändert den Speicher. Die Probe zeigt, welche Variante bei derselben Aufgabe die bessere Ausführung ermöglicht. Danach kann Harness² die tragfähigen Elemente verbinden, statt eine komplette Agentenkonfiguration nach einem einzigen fehlgeschlagenen Versuch auszutauschen. Forschungspapier zu Harness²
Erfahrungen werden für spätere Aufgaben nutzbar
Die zweite Rekursionsebene hebt den Ansatz über die Optimierung eines einzelnen Laufs hinaus. Erfahrungen aus den getesteten Änderungen fließen in einen dauerhaften Verbesserungs-Harness beziehungsweise eine Verbesserungsbibliothek ein. Spätere Aufgaben beginnen dadurch nicht zwingend wieder mit demselben unveränderten Satz an Optimierungsstrategien.
Dabei wird nicht einfach die komplette Lösung einer früheren Aufgabe kopiert. Wertvoll sind übertragbare Erkenntnisse darüber, welche Änderung unter welchen Bedingungen geholfen hat. Wenn etwa ein spezialisiertes Skript bei einer Dateitransformation zuverlässiger war als zusätzliche Prompt-Anweisungen, kann diese Erfahrung bei einer verwandten Aufgabe die Suche nach einer geeigneten Harness-Änderung lenken. Für einen anders gelagerten Auftrag kann dagegen eine Anpassung der Werkzeughinweise oder der Subagenten sinnvoller sein.
Diese Trennung verhindert, dass aufgabenspezifische Optimierung und langfristiges Lernen zu einem einzigen undurchsichtigen Mechanismus verschmelzen. Der Ausführungs-Harness bearbeitet die aktuelle Aufgabe; der Verbesserungs-Harness sammelt Erfahrungen darüber, wie solche Ausführungsumgebungen wirksam verändert werden können. Genau diese Rekursion über zwei Ebenen erklärt das Quadrat im Namen Harness². Architektur im Projekt-Repository
Parallele und sequenzielle Rekursion setzen andere Schwerpunkte
Harness² unterstützt parallele und sequenzielle Rekursion. Im parallelen Modus lassen sich mehrere vorgeschlagene Varianten unabhängig voneinander erproben. Das erleichtert den direkten Vergleich unterschiedlicher Ideen, benötigt aber mehrere Modellläufe. Im sequenziellen Modus baut eine Änderung auf den Ergebnissen des vorherigen Versuchs auf. Dadurch kann eine Variante schrittweise verfeinert werden, während frühere Entscheidungen den weiteren Suchweg stärker prägen.
Welche Form besser passt, hängt vom Experiment ab. Mehrere klar unterscheidbare Hypothesen – etwa „Skill ergänzen“, „Werkzeughinweis ändern“ und „Skript bereitstellen“ – bieten sich für parallele Proben an. Wenn dagegen eine zunächst brauchbare Konfiguration anhand des gerade beobachteten Fehlers weiterentwickelt werden soll, passt die sequenzielle Rekursion besser.
Der Experimentleitfaden sieht reproduzierbare Aufgabenauswahl sowie gespeicherte Ausführungs- und Bewertungsartefakte vor. Damit lassen sich nicht nur Endwerte vergleichen, sondern auch die vorgeschlagenen Änderungen, die einzelnen Läufe und ihre Bewertungen untersuchen. Das ist für Forschung wichtiger als eine bloße Behauptung, eine neue Konfiguration habe besser funktioniert. Experimentleitfaden
OpenCode oder Codex führen die Aufgaben aus
Als Ausführungsumgebungen nennt das Projekt OpenCode und Codex. Die mitgelieferte Konfiguration nutzt Vertex-AI-Modelle, erlaubt aber getrennte Modelle für drei Rollen: Executor, Improver und Judge. Der Executor erledigt die eigentliche Aufgabe, der Improver schlägt Änderungen am Harness vor, und der Judge bewertet die resultierenden Ausführungen.
Diese Rollentrennung eröffnet gezielte Experimente. Dasselbe Executor-Modell kann mit verschiedenen Improver-Konfigurationen verglichen werden, ohne gleichzeitig das ausführende Modell auszutauschen. Ebenso lässt sich eine einheitliche Bewertungsrolle über mehrere Harness-Varianten hinweg beibehalten. Verbesserungen werden dadurch eher der geänderten Umgebung als einem unbemerkten Modellwechsel zugerechnet.
Für Codex beschreibt die Einrichtung eine Anbindung über eine Responses-API. Eine eigenständige, allgemein angebotene Harness²-Produkt-API oder eine grafische Benutzeroberfläche gehört nicht zum beschriebenen Nutzungspfad. Gesteuert werden die Experimente über Konfigurationen und die mitgelieferten Kommandozeilenprogramme für Ausführung, Bewertung, Berichte, Einrichtung, Prüfungen, Demo und eine optionale API-Brücke. Einrichtungsanleitung Paketdefinition
Ein konkretes Experiment mit wiederkehrenden Dateiaufgaben
Ein sinnvoller Einsatz beginnt mit einer Gruppe verwandter Aufgaben, nicht mit einer einzelnen Demo. Angenommen, ein Agent soll Dokumente untersuchen, Text extrahieren und Ergebnisse in einem vorgegebenen Format ablegen. Der erste Lauf liefert die Ausgangsbasis. Anschließend kann Harness² getrennte Änderungen vorschlagen: einen präziseren Werkzeughinweis, einen Skill für das gewünschte Ausgabeformat oder ein Skript für eine wiederkehrende Konvertierung.
In den Proben bearbeitet der Executor dieselbe Aufgabe mit den Varianten. Der Judge bewertet die gespeicherten Ausführungsartefakte, und die Compose-Phase verbindet geeignete Änderungen. Nach Abschluss wird nicht nur der beste aktuelle Harness aufbewahrt: Die zweite Rekursionsebene übernimmt belastbare Erfahrungen über die wirksamen Anpassungen in die Verbesserungsbibliothek.
Bei der nächsten verwandten Aufgabe kann diese Bibliothek den Improver darauf hinweisen, dass eine deterministische Konvertierung durch ein Skript erfolgreicher war als immer ausführlichere Anweisungen. Der neue Auftrag wird trotzdem erneut ausgeführt und bewertet; die frühere Erfahrung dient als Ausgangspunkt, nicht als ungeprüfte Erfolgsgarantie. So entsteht ein nachvollziehbarer Lernpfad über mehrere Aufgaben, ohne das zugrunde liegende Modell zu trainieren.
Benchmarks zeigen den Forschungszweck
Die Autoren berichten Verbesserungen auf WorkBuddy-Bench, JobBench und LAB. Das Paper ordnet Harness² damit als Forschungsansatz ein, der sich über unterschiedliche offene Aufgaben hinweg untersuchen lässt. Ohne die jeweiligen Versuchsbedingungen und Messwerte zu betrachten, sind die Benchmarknamen jedoch kein allgemeines Leistungsversprechen für beliebige Unternehmensaufgaben.
Der Umfang kann erheblich sein: Der vollständige, im Experimentleitfaden beschriebene LAB-Aufgabenstrom enthält 1.143 Aufgaben. Werden für eine Aufgabe mehrere Harness-Varianten vorgeschlagen, ausgeführt und bewertet, vervielfacht sich die Zahl der Modellaufrufe. Das Paper weist entsprechend darauf hin, dass zusätzliche Rekursion mehr Rechenaufwand verursacht. Auch der Leitfaden macht deutlich, dass modellgestützte Läufe API-Kosten erzeugen. Experimentleitfaden Forschungspapier
Harness² ist deshalb vor allem interessant, wenn der Erkenntnisgewinn aus mehreren kontrollierten Läufen den zusätzlichen Verbrauch rechtfertigt: bei Benchmarking, Agentenforschung und systematischer Evaluation. Für eine einzelne, günstige Routineaufgabe kann die Rekursion mehr Aufwand erzeugen, als die mögliche Verbesserung einspart.
Was für einen eigenen Lauf nötig ist
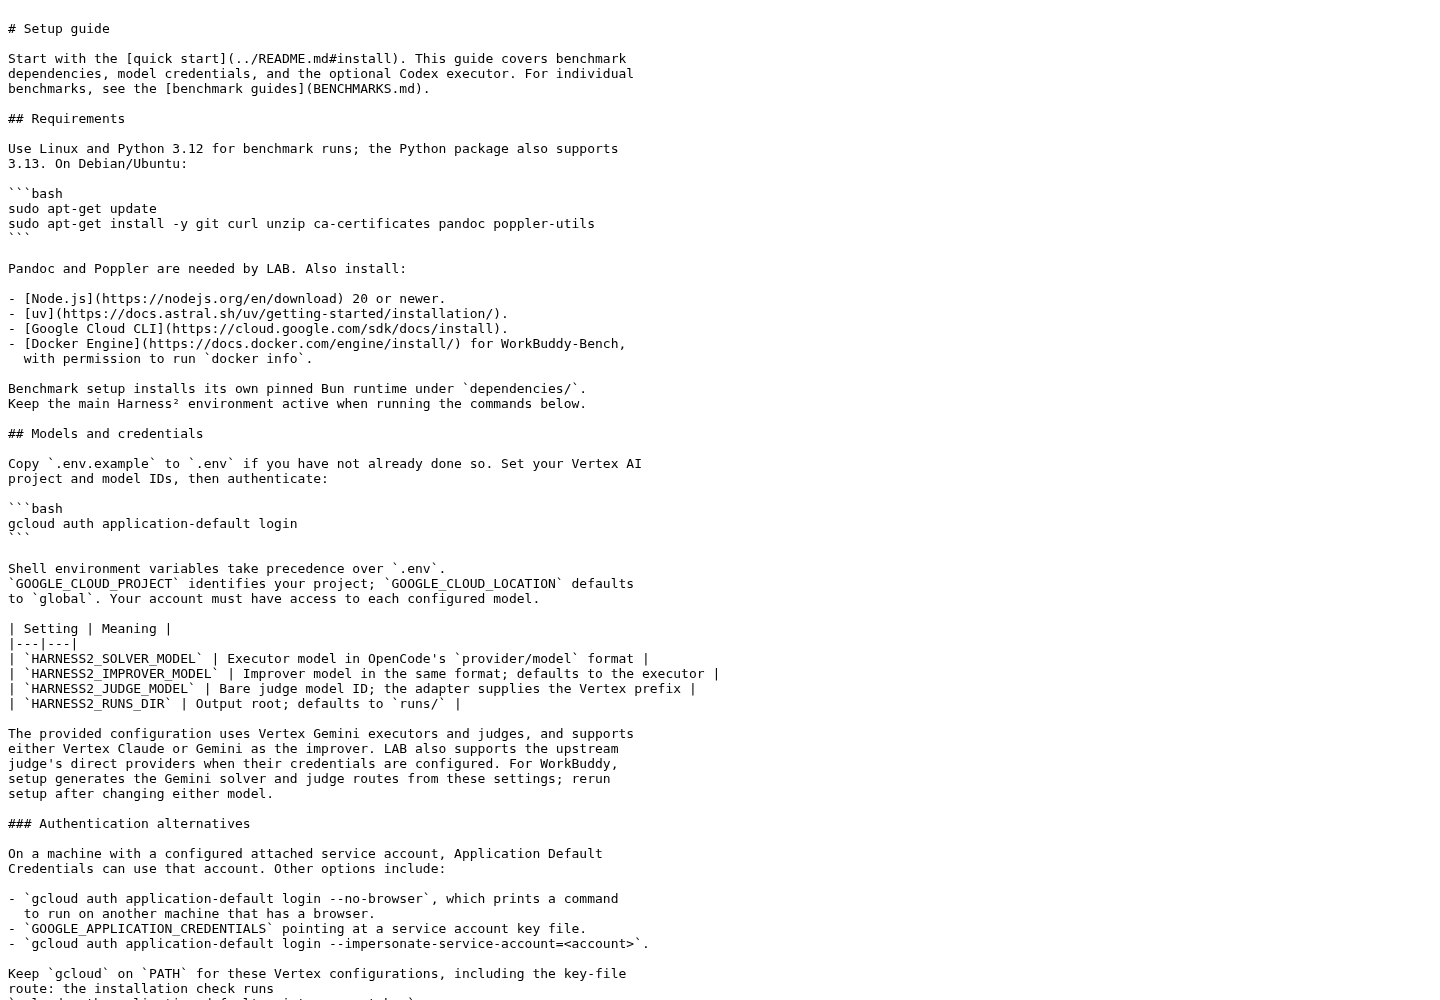
Für die dokumentierte Benchmark-Einrichtung werden Linux, Python 3.12, Node.js 20 oder neuer, uv und die Google Cloud CLI vorausgesetzt. Einzelne Benchmarks benötigen zusätzlich Docker, Pandoc oder Poppler. Die Paketdefinition nennt Python 3.12 und 3.13 auf POSIX-Systemen; veröffentlicht ist das Paket als Version 0.1.0 unter Apache 2.0. Setup-Guide pyproject.toml
Modellzugänge müssen passend zu den gewählten Executor-, Improver- und Judge-Rollen eingerichtet werden. Damit hängen die tatsächlichen Kosten von Modellen, Aufgabenzahl, Zahl der Varianten und Rekursionstiefe ab. Einen pauschalen Preis für Harness² gibt es im Projekt nicht; die Software selbst ist quelloffen, die aufgerufenen Modelle können jedoch kostenpflichtig sein.
Besondere Aufmerksamkeit verlangt der Netzwerkzugriff. Die Veröffentlichung beschränkt ihn nicht automatisch. Der Codex-Executor läuft laut Einrichtungsanleitung ohne Sandbox, und der Experimentleitfaden empfiehlt, den Zugriff auf öffentliche Benchmarks und Bewertungskriterien auf Netzwerkebene zu sperren. Andernfalls könnte ein Agent Informationen abrufen, die eine Evaluation verfälschen. Zugangsdaten, erreichbare Dienste und ausgehende Verbindungen gehören daher in eine isolierte, bewusst konfigurierte Versuchsumgebung.
Wo Harness² seinen größten Nutzen hat
Harness² passt zu Vorhaben, in denen nicht nur das Ergebnis, sondern auch die Entwicklung der Agentenumgebung untersucht werden soll. Besonders stark ist der Ansatz bei wiederkehrenden oder verwandten Aufgaben: Dort kann die Verbesserungsbibliothek Erfahrungen übertragen, während gespeicherte Artefakte sichtbar machen, welche Änderung tatsächlich zum Ergebnis beigetragen hat.
Für den praktischen Einstieg bietet sich ein begrenzter Aufgabensatz mit klarer Bewertung an. Ein festes Executor-Modell hält den Vergleich übersichtlich; wenige, deutlich unterscheidbare Änderungen zeigen, ob System-Prompt, Skill, Skript oder Werkzeughinweis den größeren Beitrag leistet. Erst wenn diese Läufe nachvollziehbare Verbesserungen liefern, lohnt sich eine breitere Rekursion über weitere Aufgaben.
Der zentrale Fortschritt liegt damit nicht in einem neuen Agentenmodell. Harness² macht den Harness selbst zum Gegenstand systematischer Anpassung und lässt die dabei gewonnenen Erfahrungen weiterwirken. Das eröffnet eine neue Experimentfläche zwischen unverändertem Modell und konkreter Aufgabe – transparent genug, um Änderungen zu untersuchen, aber rechenintensiv genug, um gezielt eingesetzt zu werden.