Cloudflare Agents SDK: web_fetch liest Webseiten und Dokumente kontrolliert ein
Der neue SDK-Baustein wandelt Webinhalte, PDFs und unterstützte Office-Dokumente in Markdown um und begrenzt Abrufe nach Host, Größe, Zeit und Weiterleitungen.
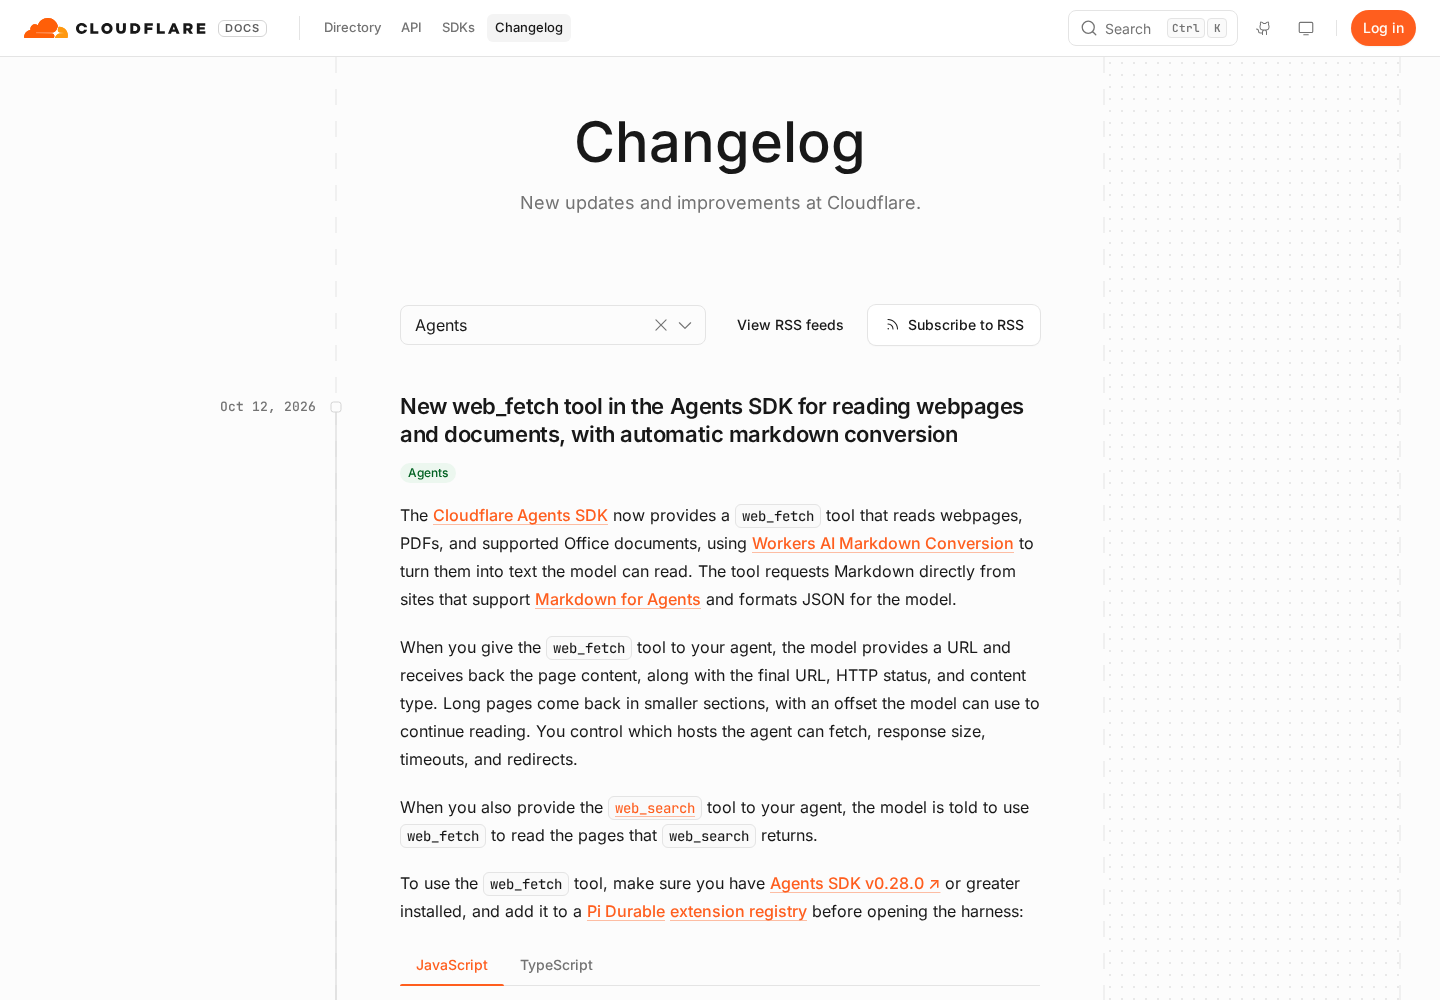
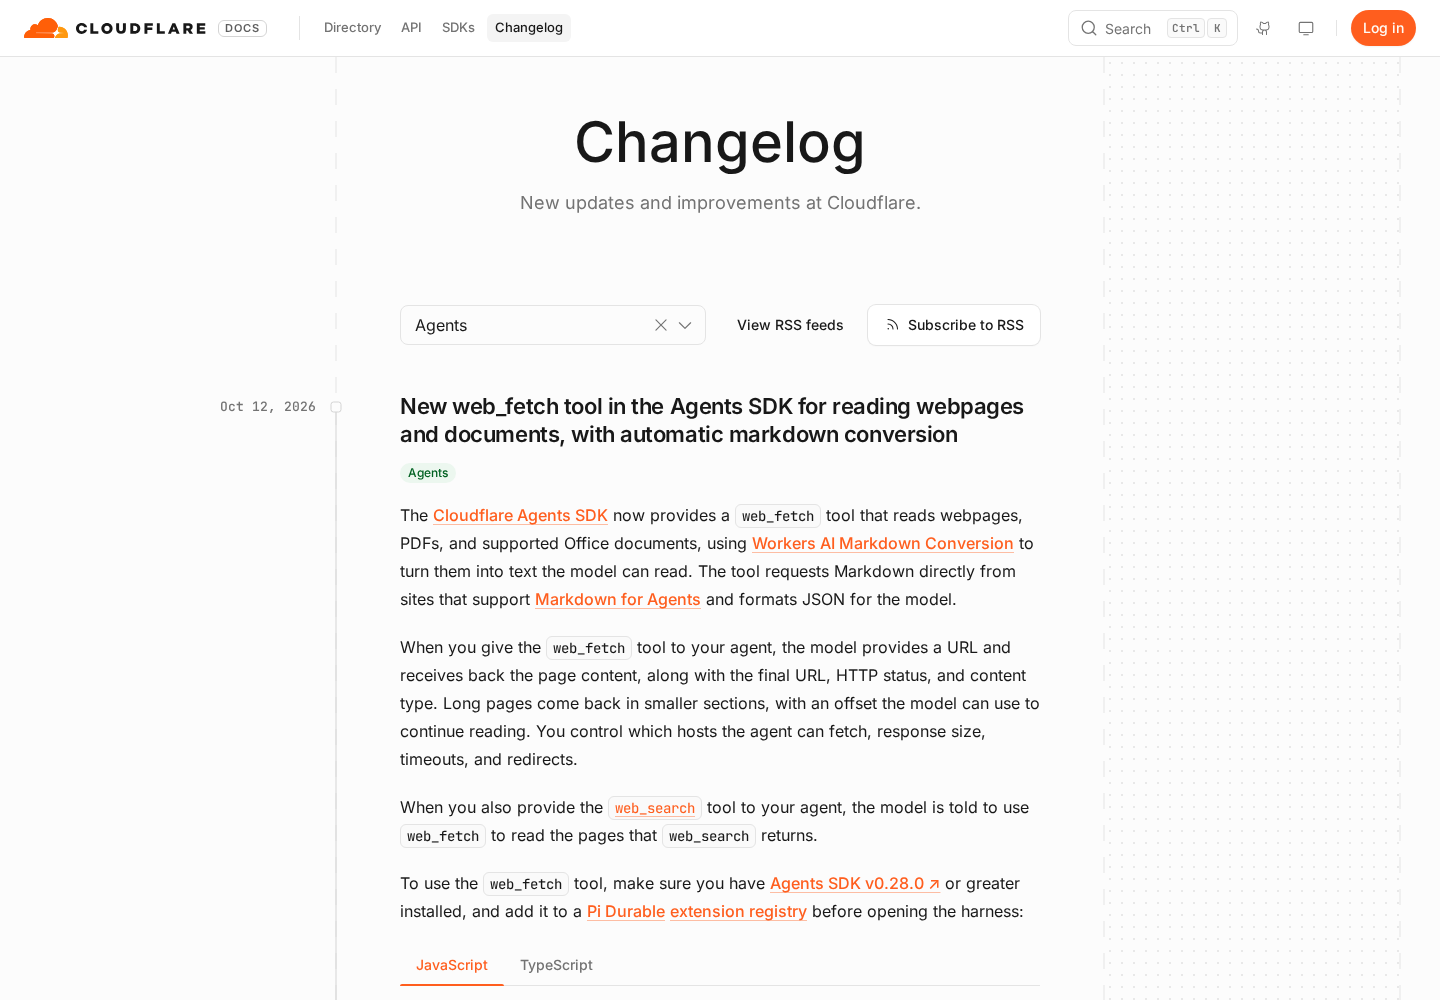
Cloudflare hat am 12. Oktober 2026 einen neuen Baustein für sein Agents SDK veröffentlicht. web_fetch ruft Webseiten, PDFs und unterstützte Office-Dokumente ab und wandelt deren Inhalt automatisch in modelllesbares Markdown um. Ein Agent kann damit nicht nur eine Adresse oder einen Suchtreffer erhalten, sondern den dahinterliegenden Inhalt unmittelbar weiterverarbeiten.
Das Interessante ist nicht allein der Abruf. Cloudflare verbindet ihn mit Vorgaben für erlaubte Hosts, Antwortgröße, Zeitlimits und Weiterleitungen. Umfangreiche Inhalte können außerdem abschnittsweise zurückgegeben werden. Dadurch lässt sich genauer festlegen, welche externen Inhalte ein Agent erreichen und wie viele Ressourcen ein einzelner Abruf beanspruchen darf.
Neu ist die Verbindung aus Abruf und Aufbereitung
Ein Sprachmodell benötigt den Informationsgehalt einer Seite, nicht deren Navigationsleisten, Layoutregeln oder Dateicontainer. Zwischen einer URL und einem verwertbaren Modellinput liegen deshalb normalerweise mehrere technische Aufgaben: Die Ressource muss geladen, ihr Typ erkannt, ihr Inhalt extrahiert und das Ergebnis in eine geeignete Textdarstellung gebracht werden.
web_fetch bündelt diese Aufgaben als Werkzeug des Agents SDK. Als Ziel können laut Cloudflare Webseiten, PDF-Dateien und unterstützte Office-Dokumente dienen. Das Resultat ist Markdown und damit eine strukturierte Textform, in der beispielsweise Überschriften, Absätze und Listen für das Modell erhalten bleiben können. Der Agent erhält also nicht lediglich den rohen HTML-Quelltext oder eine undifferenzierte Zeichenfolge.
Ausgelöst wird der Baustein durch einen Werkzeugaufruf innerhalb einer Agentenanwendung. Der zentrale Input ist die abzurufende Ressource; hinzu kommen die vom Entwickler gesetzten Zugriffsvorgaben. Der Output ist der aufbereitete Inhalt, bei langen Quellen gegebenenfalls in mehreren Abschnitten. Einen separaten Ereignis-Trigger oder einen grafischen Node nennt Cloudflare für diese Neuerung nicht: web_fetch ist die vom Agenten aufgerufene Schnittstelle.
Aus einem Suchtreffer wird auswertbarer Inhalt
Ein konkreter Einsatz beginnt mit einer Recherche. Der Agent verfügt zunächst über einen Treffer oder eine bekannte URL. Diese Adresse allein beantwortet die Nutzerfrage noch nicht. Mit web_fetch kann er die Zielseite abrufen, den extrahierten Markdown-Inhalt lesen und anschließend genau die Passagen auswählen, die für seine Aufgabe relevant sind.
Das ermöglicht eine klar getrennte Aufgabenverteilung: Die Suche identifiziert eine mögliche Quelle, web_fetch erschließt deren Inhalt und das Modell fasst ihn zusammen oder gleicht ihn mit der Ausgangsfrage ab. Die neue Fähigkeit ist damit nicht die Suche selbst, sondern der direkte Übergang vom Fundstück zur inhaltlichen Verarbeitung.
Für die Anwendung lohnt sich ein präziser Auftrag an den Agenten. Statt einer pauschalen Aufforderung wie „Lies diese Seite“ sollte feststehen, welche Information gesucht wird und welche Fundstellen ausgegeben werden sollen. Bei einer Produktdokumentation könnte der Auftrag lauten, nur unterstützte Dateitypen und konfigurierte Abrufgrenzen zu extrahieren. So verarbeitet das Modell den geladenen Text zielgerichtet, statt eine breite Zusammenfassung ohne klaren Zweck zu erzeugen.
PDFs und Office-Dokumente werden Teil derselben Werkzeugfläche
Der zweite naheliegende Anwendungsfall sind Geschäftsdokumente. Inhalte liegen häufig nicht als normale Webseite vor, sondern als PDF oder in einem Office-Format. web_fetch führt diese Quellen in dieselbe modelllesbare Ausgabe über. Eine Agentenanwendung muss deshalb für die anschließende Textarbeit nicht zwischen einer Webseite und jedem unterstützten Dokumenttyp unterscheiden.
Denkbar ist etwa die Auswertung eines veröffentlichten Berichts: Der Agent ruft das PDF ab, erhält den extrahierten Inhalt als Markdown und sucht darin nach den für den Auftrag maßgeblichen Abschnitten. Bei einem unterstützten Office-Dokument kann dieselbe Werkzeuglogik eingesetzt werden. Das ist besonders hilfreich, wenn eine Aufgabe Quellen verschiedener Formate zusammenführt und die Auswertung auf einer gemeinsamen Textdarstellung aufbauen soll.
Der Baustein übernimmt dabei nicht automatisch die Anmeldung an geschützten Quellen. Cloudflares Meldung weist für web_fetch keine eigene Authentifizierungsschicht aus. Zugriffsrechte, Sitzungen oder vorgeschaltete Freigaben bleiben daher getrennte Bestandteile der Anwendung. Für frei erreichbare oder bereits zugänglich gemachte Dokumente übernimmt das Werkzeug anschließend Abruf und Umwandlung.
Lange Quellen müssen nicht auf einmal in den Modellkontext
Lange Seiten und Dokumente sind für Agenten aus zwei Gründen anspruchsvoll: Ihr vollständiger Inhalt kann eine unnötig große Antwort erzeugen, und ein Modell benötigt für eine konkrete Frage häufig nur wenige Abschnitte. Cloudflare begegnet diesem Problem, indem web_fetch lange Inhalte abschnittsweise liefern kann.
Damit bietet sich eine selektive Lesetechnik an. Der Agent verarbeitet zunächst einen Abschnitt, identifiziert relevante Überschriften oder Textstellen und fordert danach den nächsten benötigten Teil an. Bei einem umfangreichen Handbuch kann er sich so bis zum gesuchten Kapitel bewegen; bei einem Bericht lassen sich einzelne Abschnitte nacheinander analysieren. Die Quelle bleibt dieselbe, aber die Verarbeitung wird in handliche Einheiten zerlegt.
Das schrittweise Lesen sollte mit einem eindeutigen Abbruchkriterium verbunden sein. Hat der Agent die gesuchte Angabe samt Kontext gefunden, muss er nicht automatisch den Rest des Dokuments abrufen. Fehlt sie im ersten Abschnitt, kann er fortfahren. Diese Technik nutzt die abschnittsweise Ausgabe nicht bloß als technische Notlösung, sondern als Mittel, um Modellkontext und Netzwerkzugriffe auf die tatsächliche Aufgabe auszurichten.
Host-Regeln begrenzen das erreichbare Netz
Mit erlaubten Hosts lässt sich festlegen, zu welchen Zielen web_fetch Verbindungen herstellen darf. Eine Anwendung für eine interne Wissensaufgabe kann den Abruf beispielsweise auf die dafür vorgesehenen Dokument- oder Veröffentlichungsdomains beschränken. Eine vom Modell erzeugte oder aus einem Dokument übernommene Adresse führt dann nicht automatisch zu einem beliebigen Ziel außerhalb dieses Rahmens.
Diese Vorgabe ist besonders wichtig, weil URLs selbst Daten sein können. Ein Suchergebnis, eine geladene Seite oder ein Dokument kann weitere Verweise enthalten. Ohne eine Zielbegrenzung könnte ein Agent versuchen, ihnen zu folgen, obwohl sie für den Auftrag nicht vorgesehen sind. Die Host-Auswahl definiert deshalb die erreichbare Oberfläche der jeweiligen Agentenfunktion.
Weiterleitungen benötigen eine eigene Grenze. Eine zunächst erlaubte Adresse kann auf ein anderes Ziel verweisen oder mehrere Stationen durchlaufen. Durch die Begrenzung von Weiterleitungen bleibt auch dieser Teil des Netzwerkverhaltens kontrollierbar. Host-Regeln und Weiterleitungsgrenzen beantworten dabei unterschiedliche Fragen: Die eine bestimmt, welche Ziele zulässig sind, die andere, wie weit ein Abruf einer Umleitung folgen darf.
Größe und Zeit setzen jedem Abruf einen Rahmen
Neben dem Ziel kann auch der Ressourcenverbrauch begrenzt werden. Eine maximale Antwortgröße verhindert, dass ein einzelner Abruf unbegrenzt viele Daten übernimmt. Das ist nicht identisch mit der abschnittsweisen Ausgabe: Die Größenbegrenzung setzt einen Rahmen für die Antwort, während die Aufteilung umfangreichen Inhalt in verarbeitbare Teile gliedert.
Das Zeitlimit begrenzt, wie lange der Abruf auf eine Antwort warten darf. Langsame oder nicht reagierende Ziele halten den Werkzeugaufruf damit nicht unbegrenzt offen. Für den Agenten sind solche Begrenzungen klare Endzustände eines Abrufversuchs: Ein wegen Host-Regel, Größe, Zeit oder Weiterleitung nicht ausführbarer Zugriff sollte nicht durch eigenmächtiges Variieren der Zieladresse umgangen werden.
Konkrete Zahlen für diese Einstellungen nennt Cloudflare in der Meldung nicht. Die passenden Werte hängen deshalb vom vorgesehenen Dokumentumfang und von der Aufgabe ab. Eine Anwendung, die kurze Produktseiten liest, benötigt einen anderen Rahmen als eine Anwendung für lange Berichte. Entscheidend ist, die Optionen bewusst pro Einsatzprofil festzulegen und nicht jeden Agenten mit derselben Reichweite auszustatten.
So nutzt man web_fetch für belastbare Antworten
Die beste Anwendungstechnik trennt Quellenabruf, Inhaltsauswahl und Antwortbildung. Zuerst erhält web_fetch die konkrete Adresse innerhalb der erlaubten Hosts. Danach untersucht der Agent den gelieferten Markdown-Abschnitt auf die gesuchte Information. Erst wenn die maßgeblichen Passagen feststehen, formuliert das Modell seine Antwort. Diese Trennung macht nachvollziehbar, welche Aussage auf welchem geladenen Inhalt beruht.
Bei mehreren Quellen sollte jede URL einzeln verarbeitet werden. Der Agent kann zunächst die relevanten Stellen aus Quelle A sichern, anschließend Quelle B lesen und erst danach Gemeinsamkeiten oder Unterschiede formulieren. So bleibt erkennbar, welche Information aus welchem Dokument stammt. Das ist sinnvoller, als große Mengen verschiedener Texte ohne Zuordnung in einen einzigen Modellinput zu legen.
Auch Folgeabrufe sollten zweckgebunden sein. Enthält ein Dokument einen Link, ist dieser nicht automatisch erforderlich. Der Agent folgt ihm nur, wenn die ursprüngliche Frage ohne die zusätzliche Quelle nicht beantwortet werden kann und das Ziel innerhalb der erlaubten Hosts liegt. Die Weiterleitungs- und Host-Vorgaben bilden dabei die technische Grenze; der konkrete Rechercheauftrag bildet die inhaltliche Grenze.
Wo der neue Baustein besonders gut passt
web_fetch eignet sich für Agenten, die bekannte Web- oder Dokumentquellen lesen und daraus gezielt Informationen gewinnen sollen. Dazu zählen die Auswertung eines Suchtreffers, die Analyse einer Produktdokumentation und das Erschließen eines bereitgestellten Berichts. In allen drei Fällen liefert die Quelle den Inhalt, web_fetch macht ihn als Markdown zugänglich und das Modell übernimmt die inhaltliche Arbeit.
Weniger passend ist der Baustein als Ersatz für eine Anmeldung, eine Suchmaschine oder eine dauerhafte Dokumentenablage. Diese Aufgaben sind nicht Bestandteil der angekündigten Funktion. Ebenso sollte die abschnittsweise Lieferung nicht mit einer vollständigen Indexierung verwechselt werden: Sie stellt lange Inhalte portionsweise bereit, baut daraus aber nicht automatisch eine langfristig durchsuchbare Wissensbasis.
Der praktische Gewinn liegt damit in einer eng umrissenen Verbindung. Cloudflare macht externe Inhalte für Agenten direkt lesbar und gibt dem Betrieb zugleich Stellschrauben für Ziel, Datenmenge, Laufzeit und Weiterleitungen. Das reduziert die technische Distanz zwischen einer gefundenen Ressource und ihrer Auswertung, ohne den Netzwerkzugriff des Agenten grenzenlos zu öffnen.
Quelle: Cloudflare Agents Changelog, Eintrag vom 12. Oktober 2026.